
En 2026, la capacité des grands modèles de langage à ingérer des volumes massifs de données est passée d'une innovation technique à un standard industriel. Les architectures phares actuelles gèrent désormais une fenêtre de contexte atteignant le million de jetons, permettant l'analyse directe de bases de code complètes ou de vastes corpus documentaires.
Pourtant, le traitement frontal de ces historiques lourds soulève des défis d'infrastructure majeurs. L'explosion de la consommation de VRAM et la dégradation de la précision pour les informations centrales — le phénomène du Lost in the Middle — obligent à repenser les stratégies d'intégration. Au-delà de la simple compréhension des mécanismes des modèles génératifs, ce guide décrypte les enjeux techniques actuels. L'objectif est de comparer les solutions du marché, comme celles de DeepSeek ou Google, et d'arbitrer efficacement entre l'usage d'un LLM à long contexte et le déploiement d'une architecture RAG.
En bref : la synthèse sur les fenêtres de contexte étendues
Voici l'essentiel à retenir sur l'évolution et l'usage des modèles à long contexte.
- Les fenêtres de contexte massives, standardisées autour de 1,05 million de jetons, permettent de traiter l'équivalent de plusieurs livres en une seule requête.
- Le choix entre une architecture RAG et un modèle étendu repose sur des critères de latence, de fraîcheur des données et de coûts d'infrastructure, d'autant que le problème de perte d'information centrale (Lost in the Middle) persiste.
- L'exploitation de ces modèles en production exige des optimisations techniques strictes, telles que le KV Caching, le FlashAttention et le FlashPrefill, pour limiter la consommation de VRAM.
- L'effondrement des tarifs d'inférence rend ces usages accessibles, Google DeepMind affichant par exemple un coût d'entrée de 2,00 $ par million de tokens sur son modèle actuel Gemini 3.1 Pro.
Comprendre le fonctionnement des LLM à long contexte
La fenêtre de contexte représente la mémoire de travail immédiate d'un modèle de langage. Elle définit la quantité de texte, mesurée en jetons, que l'intelligence artificielle peut analyser simultanément pour générer sa réponse.
L'ingestion intégrale des documents
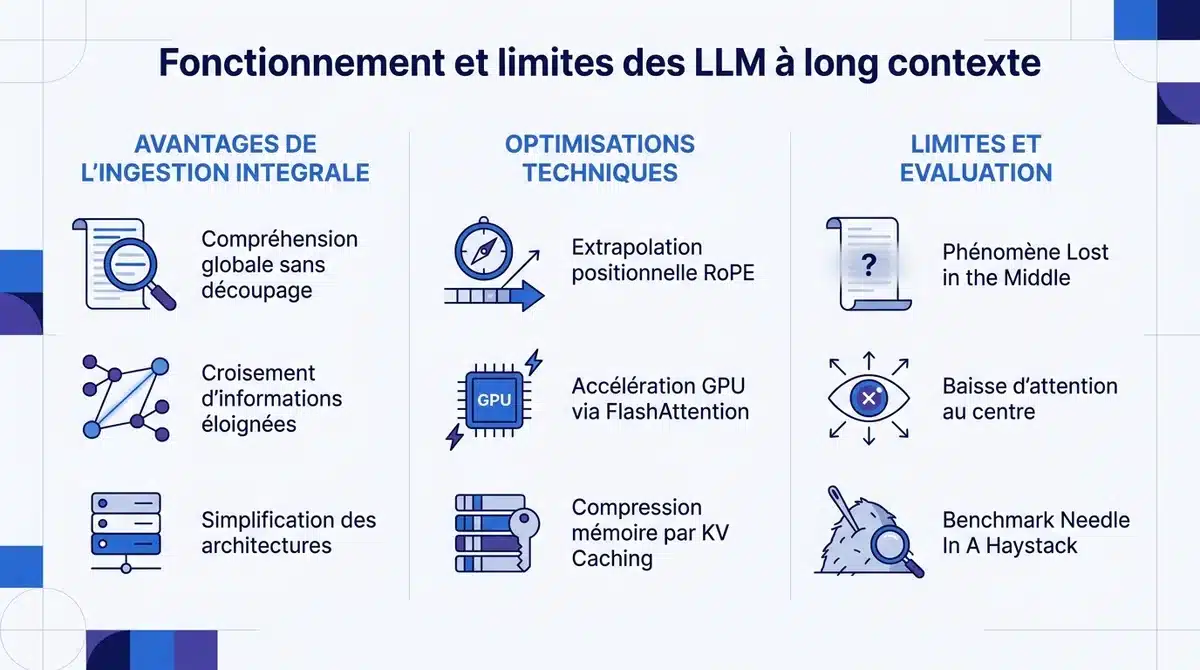
Historiquement, l'analyse de longs documents nécessitait un découpage arbitraire du texte. Aujourd'hui, les architectures modernes permettent d'ingérer un corpus dans son intégralité. Cette approche offre plusieurs avantages directs :
- Une compréhension globale du document sans perte de sens liée à la segmentation.
- La capacité de croiser des informations éloignées au sein d'un même texte.
- Une simplification de l'architecture logicielle en évitant les bases de données vectorielles complexes.
En 2026, la capacité standard s'échelonne de 128 000 jetons à 1 million de jetons pour des versions comme Gemini 1.5 Pro ou Claude Sonnet 4.6 d'Anthropic. Cela équivaut à traiter d'un seul bloc un volumineux corpus de plusieurs centaines de pages de texte.
Les mécanismes techniques derrière le passage à l'échelle
L'augmentation de cette capacité d'absorption ne repose pas uniquement sur l'ajout de puissance brute. Le traitement de contextes très longs exige des modifications profondes du mécanisme d'attention classique pour éviter l'explosion des besoins en VRAM.
Les ingénieurs s'appuient sur plusieurs techniques d'optimisation :
- L'extrapolation du codage positionnel (RoPE) pour aider le modèle à se repérer dans des séquences immenses.
- L'utilisation de noyaux optimisés comme FlashAttention pour accélérer le calcul d'attention sur les GPU.
- La compression de la mémoire tampon via le KV Caching.
- La mise en cache des requêtes récurrentes pour réduire le coût de calcul lors de l'inférence.
Les limites de l'attention et l'évaluation du rappel
Malgré ces avancées matérielles, le fonctionnement interne des LLM conserve une faiblesse structurelle. Les modèles ont tendance à accorder moins d'attention à la zone centrale du texte fourni.
Ce phénomène, connu sous le nom de Lost in the Middle, se traduit par une variance d'erreur de 10 % à 25 % lorsque l'information pertinente est enfouie au milieu du prompt. Pour mesurer cette efficacité réelle, l'industrie utilise le benchmark Needle In A Haystack. En 2026, ces tests évoluent vers des scénarios multi-aiguilles (NeedleChain) afin de vérifier si l'IA parvient à relier plusieurs faits dispersés dans un vaste document.
LLM à long contexte vs RAG : le comparatif stratégique
L'interrogation de vastes corpus documentaires oppose traditionnellement deux méthodes : l'injection directe dans le modèle et la génération augmentée par la recherche. En 2026, le choix entre ces approches repose sur des critères stricts liés aux coûts d'infrastructure et à la fiabilité.
Coûts et latence : l'impact sur les architectures d'entreprise
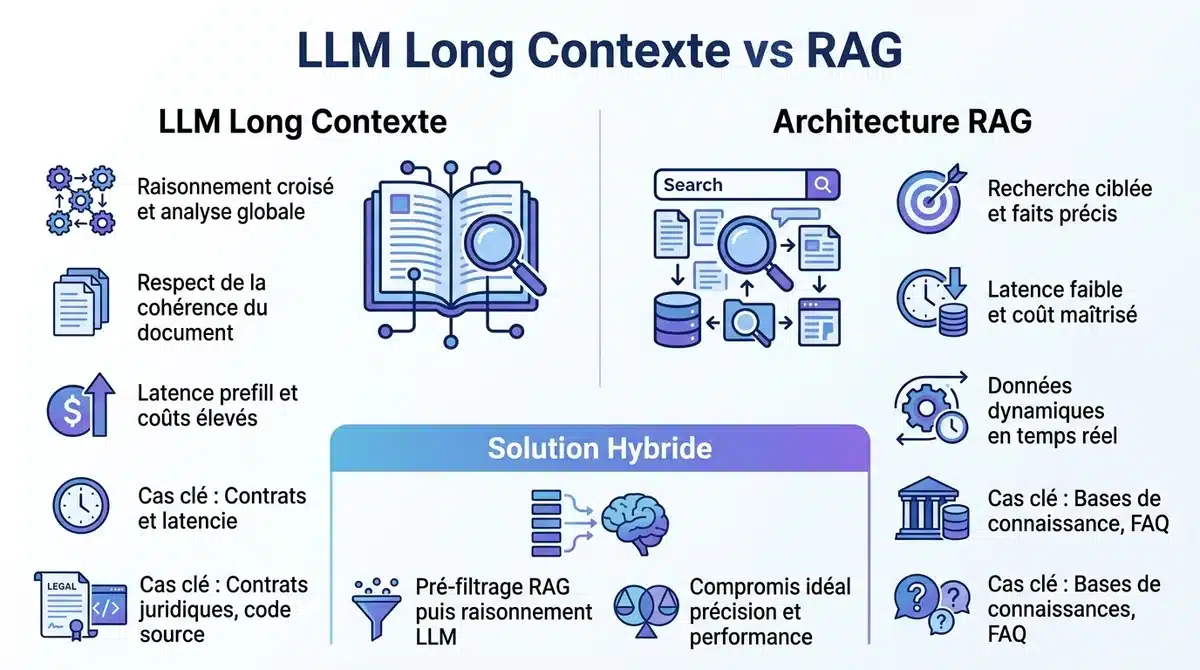
L'ingestion massive de données dans un LLM à long contexte allonge mécaniquement la phase de calcul initial, appelée prefill. Cette étape dégrade le temps d'émission du premier jeton (TTFT), ce qui ralentit la vitesse de réponse globale de l'application. À l'inverse, un système RAG maintient une latence très faible en ne soumettant que les extraits strictement nécessaires à la requête.
Sur le plan financier, la facturation des modèles s'indexe directement sur le volume de jetons soumis en entrée. L'envoi systématique de corpus exhaustifs dans un prompt étendu génère des coûts d'infrastructure nettement supérieurs à la maintenance d'une base vectorielle ciblée. Cet arbitrage financier est d'autant plus critique que le prix des jetons de sortie, générés lors des phases de raisonnement, s'avère structurellement plus élevé que celui des requêtes.
Pour maîtriser ces dépenses et préserver l'interactivité, les déploiements s'appuient sur des stratégies de routage dynamique et de mise en cache :
- Le Prompt Caching mémorise les segments de texte récurrents pour éviter de facturer à nouveau leur traitement lors de requêtes successive.
- Les routeurs intelligents délèguent les requêtes simples à des modèles plus légers et rapides.
- Les modèles d'élite sont strictly réservés aux tâches exigeant une analyse croisée complexe sur l'ensemble du document.
Précision, pertinence et émergence des architectures hybrides
Le choix entre un LLM à long contexte et un système de recherche externe repose sur un compromis strict entre la compréhension globale et l'exactitude factuelle. L'ingestion directe d'un document complet préserve la cohérence d'ensemble en évitant la fragmentation de l'information, un risque inhérent au découpage en segments (chunking) des bases vectorielles.
Cependant, cette approche expose le modèle à une forte sensibilité à la dilution des données et aux hallucinations. Les benchmarks récents, comme RULER et LongBench v2, révèlent une dégradation de la précision pouvant atteindre 30 % lorsque l'information pertinente se trouve au milieu du document.
Pour limiter cette dégradation tout en tirant parti du raisonnement global, la norme s'oriente désormais vers une approche combinée :
- Le système de recherche pré-filtre la base documentaire pour extraire un sous-ensemble restreint et pertinent.
- Le LLM à long contexte applique ensuite ses capacités de raisonnement croisé sur cette sélection.
Cette synergie permet d'équilibrer la consommation de ressources tout en garantissant la fraîcheur des données d'entreprise. Voici une matrice de choix basée sur les cas d'usage dominants en 2026 :
| Cas d'usage | Solution recommandée | Justification technique |
|---|---|---|
| Analyse de contrats juridiques complexes | Long contexte (ex: Claude Opus) | Nécessite un raisonnement croisé sur l'ensemble du document sans briser les clauses interdépendantes. |
| Exploration de bases de code complètes | Long contexte (ex: Gemini 3 Pro) | Maintien de la logique globale de l'architecture logicielle et de la hiérarchie des dépendances. |
| Interrogation de bases de données dynamiques | Architecture RAG | Exige une extraction de faits précis et une mise à jour en temps réel, limitant le risque de dégradation du contexte. |
Panorama des modèles phares du marché à fenêtre étendue
En 2026, l'écosystème des LLM à long contexte s'est structuré autour de quelques acteurs dominants capables de traiter des volumes documentaires massifs. Cette standardisation s'accompagne d'une refonte des grilles tarifaires pour faciliter l'ingestion de bases de code complètes.
L'alignement des leaders sur le standard industriel
La capacité d'un million de jetons en entrée constitue désormais la norme pour les modèles de premier plan. Les entreprises s'appuient principalement sur trois familles d'architectures pour leurs déploiements complexes :
- La gamme Claude 5 développée par Anthropic.
- La génération Gemini 3.1 Pro proposée par Google.
- La série GPT-5.6 d'OpenAI.
Pour encourager l'adoption de ces vastes fenêtres, les fournisseurs ont supprimé les anciens surcoûts liés au contexte étendu. Anthropic propose son modèle Claude Sonnet 5 à un tarif unifié de 2,00 $ par million de tokens d'entrée, un positionnement tarifaire sur lequel Google s'est également aligné pour sa gamme Gemini 3.
La pression tarifaire des modèles efficients
Face aux acteurs historiques, le marché se caractérise par une forte polarisation des prix sous l'impulsion de nouvelles architectures optimisées. L'entreprise DeepSeek illustre cette dynamique avec son modèle DeepSeek V4 Flash, qui permet d'ingérer de grands volumes de données pour 0,14 $ le million de tokens d'entrée.
Toutefois, la taille brute de la fenêtre de contexte ne suffit plus à départager ces solutions. Les comparatifs d'évaluation insistent systématiquement sur la précision de restitution des données enfouies. Face au risque persistant d'oubli des informations centrales, les intégrateurs privilégient la prudence en combinant ces grands modèles avec des systèmes RAG pour sécuriser la fiabilité des réponses.
Gemini et Claude : les performances sur les très longs contextes
Google se distingue par la capacité d'ingestion brute de ses architectures. La famille Gemini, en s'appuyant sur les avancées de la génération Gemini 3 (notamment Gemini 3.1 Pro), gère de manière fluide des fenêtres de contexte atteignant un million de jetons. Cette solution se démarque par son efficacité lors du traitement de vastes corpus au sein même du prompt étendu.
- Analyse simultanée de vastes dépôts de code et de documentations techniques.
- Ingestion directe de très grands volumes de données.
De son côté, l'écosystème d'Anthropic privilégie la finesse d'analyse sur des volumes ciblés. La gamme Claude, incluant Claude Sonnet 5, propose une approche orientée vers l'exactitude. Les évaluations portant sur la restitution d'informations cachées au milieu de longs contextes mettent en évidence les enjeux de précision lors de l'interrogation d'un LLM à long contexte.
Alors que Gemini s'impose pour l'absorption de volumes massifs, les comparatifs montrent que Claude conserve un avantage sur la précision du suivi d'instructions complexes et le raisonnement méthodique sur de longs textes. Sur le plan financier en 2026, le traitement de ces vastes corpus via l'API d'un modèle performant comme Claude Sonnet 5 s'établit à 2,00 $ par million de tokens en entrée, selon les données tarifaires d'Anthropic.
DeepSeek et Qwen : les alternatives open-weight efficientes
L'écosystème open-weight propose désormais des alternatives robustes pour le traitement de vastes corpus en local. Des modèles comme DeepSeek dans sa version V4 et d'autres architectures ouvertes gèrent de très larges fenêtres de contexte. Distribuées sous licences permissives, ces solutions permettent aux entreprises de déployer un LLM à long contexte souverain sans dépendre des fournisseurs cloud traditionnels.
L'auto-hébergement de ces architectures massives nécessite de contourner les limits matérielles habituelles. Pour y parvenir, ces modèles intègrent des mécanismes d'attention éparse et des architectures basées sur un mélange d'experts (MoE).
- Ces optimisations réduisent significativement la consommation de VRAM par rapport aux mécanismes d'attention dense.
- Elles facilitent l'exécution de modèles performants sur des serveurs d'entreprise standards.
Sur le plan financier, cette nouvelle génération redéfinit l'économie de l'intelligence artificielle générative. L'efficience de ces modèles ouverts, couplée à la garantie de confidentialité des données, les positionne comme des moteurs de choix pour alimenter des pipelines RAG internes à grande échelle.
Enjeux d'infrastructure et d'optimisation technique
Le déploiement de modèles capables d'ingérer des millions de mots se heurte aux limites physiques du matériel. En 2026, l'industrie déploie des trésors d'ingénierie pour éviter que les serveurs ne s'effondrent sous le poids de la mémoire requise.
Le goulet d'étranglement de la mémoire GPU
L'augmentation de la fenêtre de contexte au-delà du million de jetons impose une charge colossale sur les composants matériels. Pendant la phase d'inférence, le stockage des calculs intermédiaires sature rapidement les ressources disponibles.
Cette mémoire temporaire, appelée KV cache (Key-Value), peut monopoliser jusqu'à 80 % de la VRAM d'un processeur graphique. Cette contrainte limite drastiquement le nombre de requêtes simultanées qu'un serveur peut traiter.
Quantification et architectures multi-niveaux
Pour contourner ce mur matériel, les ingénieurs réduisent l'empreinte mathématique des données stockées. Le passage au format FP8 pour le KV Caching s'est imposé comme un standard sur les accélérateurs récents, divisant par deux l'espace mémoire nécessaire sans dégrader la qualité des réponses.
En parallèle, des frameworks spécialisés comme LMCache orchestrent une gestion de cache à plusieurs niveaux. Ils transfèrent dynamiquement les données de la carte graphique vers d'autres supports :
- La mémoire vive classique (RAM) du processeur central.
- Les disques SSD NVMe locaux pour le stockage à froid.
Cette architecture distribuée permet de dépasser les limites physiques d'un GPU isolé lors de l'analyse de très longs documents.
Réutilisation du contexte et moteurs d'inférence
Le recalcul systématique d'un long historique génère une latence inacceptable pour les applications interactives. Les moteurs d'inférence de référence, tels que vLLM avec son mécanisme PagedAttention ou SGLang via RadixAttention, automatisent désormais la mise en cache des préfixes.
Cette technique mémorise l'analyse des segments de texte déjà soumis au modèle. Lors d'une conversation à plusieurs tours, le système réutilise ces calculs antérieurs, allégeant ainsi considérablement les coûts d'infrastructure.
Optimisation de la VRAM : KV Caching et gestion du contexte
Le KV Caching joue un rôle stratégique en mémorisant l'état mathématique des jetons déjà traités pour éviter de les recalculer. Sur des fenêtres de contexte atteignant ou dépassant le million de tokens, le stockage de ce cache peut monopoliser jusqu'à 80 % de la mémoire VRAM du GPU pendant l'inférence.
Pour gérer efficacement la VRAM lors de requêtes simultanées à fort volume, les infrastructures s'appuient sur deux leviers majeurs :
- La pagination de la mémoire et l'optimisation des préfixes (via des moteurs comme vLLM avec PagedAttention ou SGLang avec RadixAttention) pour éviter la recomputation coûteuse du contexte lors de requêtes répétées.
- L'adoption du format de quantification FP8 pour le stockage du KV cache, qui permet de diviser par 2 la mémoire requise par requête sans dégrader notablement la précision du modèle.
La phase initiale de lecture des prompts très longs génère une latence importante avant la production des premiers jetons. Pour accélérer cette étape, l'industrie s'appuie sur la réutilisation automatisée du cache et l'optimisation des flux de traitement.
En complément, des frameworks spécialisés comme LMCache déploient des architectures multi-niveaux pour transférer dynamiquement le KV cache de la VRAM GPU vers la RAM du CPU ou les SSD NVMe locaux. Cette approche permet de réduire le temps d'attente tout en dépassant les limites physiques de mémoire d'un GPU unique, rendant l'usage d'un LLM à long contexte viable pour des applications interactives.
Les pièges du rappel : Lost in the Middle et Needle In A Haystack
L'ingestion de volumes massifs de texte met en lumière un biais d'attention persistant en forme de « U » au sein des architectures neuronales. Ce phénomène, qualifié de Lost in the Middle, démontre que les modèles peinent à restituer une information enfouie au cœur d'un texte étendu. Le système privilégie mécaniquement le traitement des données situées au début et à la fin du document.
Pour évaluer cette défaillance, l'industrie s'appuie historiquement sur le test Needle In A Haystack (NIAH), consistant à cacher un fait précis dans un vaste corpus. En 2026, ces évaluations synthétiques à fait unique sont délaissées au profit d'épreuves complexes exigeant de croiser plusieurs faits noyés dans le bruit. Sur ces nouveaux standards, les modèles les plus performants parviennent à maintenir un niveau de précision élevé.
Face à ces limites de rappel, l'optimisation de la structure du prompt s'avère indispensable pour exploiter un LLM à long contexte. Les bonnes pratiques d'ingénierie recommandent d'appliquer un réordonnancement des données, souvent appelé prompt re-packing :
- Placer les instructions critiques et les faits majeurs aux extrémités de la requête.
- Privilégier un filtrage préalable via une architecture RAG plutôt que l'injection brute de documents.
Cette structuration garantit que les éléments déterminants échappent à la zone d'oubli central lors de la phase d'inférence.
Foire aux questions sur les fenêtres de contexte
- Quelle est la différence entre la fenêtre de contexte d'un LLM et sa mémoire à long terme ?
- La fenêtre de contexte agit comme la mémoire de travail immédiate de l'intelligence artificielle. Elle contient uniquement les informations fournies dans la requête en cours, une capacité désormais standardisée sur les familles de modèles comme GPT-5.6 ou Gemini 3.
À l'inverse, la mémoire à long terme réside dans les poids neuronaux figés lors de l'entraînement initial. Une fois la session terminée, le LLM à long contexte oublie instantanément les documents soumis, nécessitant de les recharger à chaque nouvelle interaction.
- Les LLM à long contexte ont-ils vocation à remplacer définitivement les architectures RAG ?
- Non, ces deux approches demeurent strictement complémentaires en 2026. Bien que des modèles ouverts comme Meta Llama 4 Scout affichent des capacités d'ingestion extrêmes, le traitement de corpus massifs engendre des contraintes économiques majeures.
Les fournisseurs appliquent d'ailleurs de fréquentes majorations tarifaires dès le franchissement du palier des 200 000 tokens. De plus, la dégradation de la précision effective sur les très longs documents oblige à maintenir une brique RAG pour garantir l'exactitude factuelle.
- Comment tester efficacement la capacité de restitution d'un modèle sur un document très volumineux ?
- L'évaluation ne doit plus se limiter à la taille théorique annoncée par l'éditeur. Il est impératif de mesurer la fenêtre effective en insérant des informations spécifiques au centre du corpus, là où l'attention du modèle chute naturellement.
Cette méthode permet de vérifier si l'architecture subit le phénomène du Lost in the Middle. Si la restitution échoue, cela indique que la limite opérationnelle est atteinte, indépendamment du plafond technique commercialisé.
Conclusion
L'évolution des LLM à long contexte en 2026 démontre que la taille brute de la fenêtre d'analyse ne se suffit plus à elle-même. Face au phénomène de dégradation de l'information (context rot), l'industrie s'oriente vers une complémentarité stricte. L'ingestion massive de données s'appuie systématiquement sur une architecture RAG pour le pré-filtrage, couplée à des optimisations matérielles comme le KV Caching pour maîtriser les coûts d'infrastructure.
L'avenir du traitement documentaire repose désormais sur la spécialisation via des passerelles multi-modèles (LLM Gateways). Plutôt que de s'appuyer sur une intelligence artificielle unique, les entreprises routent dynamiquement leurs requêtes. Elles délèguent par exemple la recherche documentaire étendue à des modèles de la famille Gemini 3, confient l'analyse de code complexe à Claude 5, et absorbent les volumes massifs avec des architectures adaptées. Cette hybridation garantit un équilibre optimal entre précision factuelle, latence et budget.


